目标地址http://scxk.nmpa.gov.cn:81/xk/
这个网站单击链接时地址不会发生任何变化
如果直接爬取网页会得到类似这样的
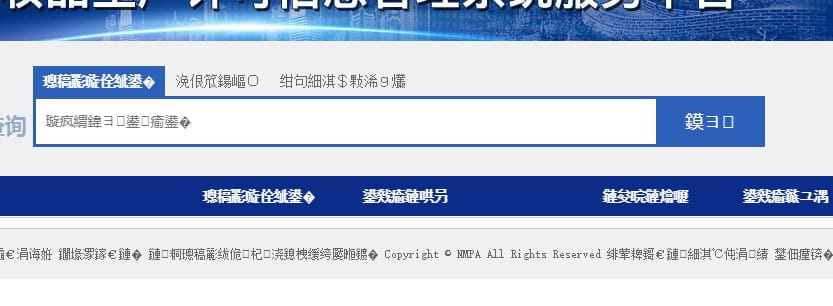
原因是所有的页面和详细信息包括主页都是以ajax异步方式获取的
通过抓包工具获得一个post数据包
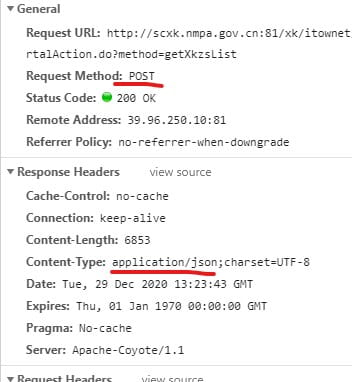
这个数据包传递一组页面参数后返回一和json字符串,里面有一个ID
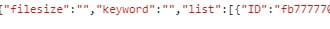
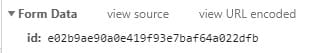
详情页面也是异步加载的,通过这个ID传参进去可以获取需要的数据
做测试只爬取了5页信息:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
|
'''
@文件 :spider.py
@Time :2020-12-29 20:56:42
@Author :Karcyril
@Software:Visual Studio Code
'''
import requests
import json
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3775.400 QQBrowser/10.6.4208.400'
}
listId = []
detailList = []
for page in range(1, 6):
params = {
'on': ' true',
'page': page,
'pageSize': ' 15',
'productName': '',
'conditionType': ' 1',
'applyname': '',
'applysn': '',
}
postUrl = 'http://scxk.nmpa.gov.cn:81/xk/itownet/portalAction.do?method=getXkzsList'
respJson = requests.post(url=postUrl, data=params, headers=headers).json()
for item in respJson['list']:
listId.append(item['ID'])
for id in listId:
subPostUrl = 'http://scxk.nmpa.gov.cn:81/xk/itownet/portalAction.do?method=getXkzsById'
subParam = {
'id': id,
}
detailJson = requests.post(
url=subPostUrl, data=subParam, headers=headers).json()
detailList.append(detailJson)
with open('./test.json', 'w+', encoding='utf-8') as fp:
json.dump(detailList, fp, ensure_ascii=False)
|
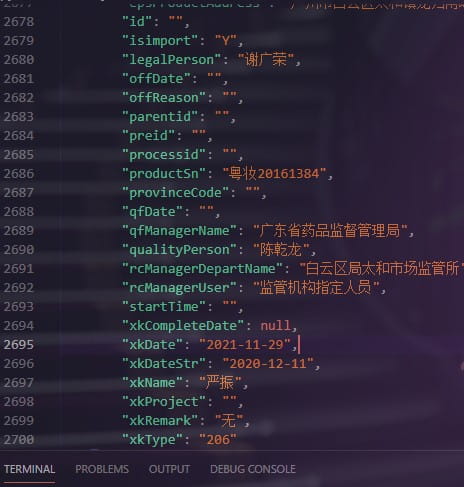
结果如下,没有做任何处理只是简单的储存了一下

 微信